Virtual Clusters
Dies ist eine ausführliche Anleitung für Virtual Clusters (Cloud Native Deployments). Einen Überblick über alle Runtime-Typen und Hilfestellung bei der Auswahl findest du unter Runtimes Übersicht.
Mit Virtual Clusters lassen sich Kubernetes-Workloads innerhalb der Codesphere-Infrastruktur ausführen. Jeder Virtual Cluster stellt eine dedizierte Kubernetes-Umgebung für deine Resource Group bereit und unterstützt Standard-Kubernetes-Workloads und -Tools.
Jeder Virtual Cluster ist isoliert und verfügt über eine eigene Control Plane sowie eigene Ressourcengrenzen. Workloads können unabhängig und sicher von anderen Resource Groups bereitgestellt, aktualisiert und entfernt werden.
Virtual Clusters sind als Managed Services innerhalb von Codesphere implementiert. Jeder Virtual Cluster läuft als Managed-Kubernetes-Umgebung. Codesphere verwaltet die zugrunde liegende Infrastruktur, während Virtual Clusters dir die Vorteile der Kubernetes-APIs bieten und deine nativen Workloads und Abhängigkeiten unterstützen.
Diese Funktion richtet sich an fortgeschrittene Nutzer mit Erfahrung in Kubernetes. Wenn du keinen direkten Zugriff auf Kubernetes-Primitive benötigst, verwende für einfachere Workflows besser einen anderen Typ der Codesphere Runtimes.
Kompatibilität
Virtual Clusters sind für Kubernetes-native Workloads konzipiert. Du kannst eigene Kubernetes-Abhängigkeiten mitbringen und vertraute Tools wie Helm-Charts nutzen, um Anwendungen und Services direkt in das Codesphere-Ökosystem zu deployen.
Virtual Clusters folgen standardmäßig den Kubernetes Pod Security Standards auf der Stufe restricted. Das bedeutet, dass Workloads privilegierte oder Host-Level-Zugriffsmuster vermeiden und gehärtete Pod- und Container-Sicherheitseinstellungen einhalten müssen. Manche Helm-Charts oder Manifeste von Drittanbietern erfordern eventuell Konfigurationsänderungen, bevor sie ausgeführt werden können.
Typische Anpassungen sind:
- Container als Nicht-Root-Benutzer ausführen
- Privilegierte Container und Privilege Escalation deaktivieren
- Host-Namespaces, Host-Pfade und Host-Ports vermeiden
- Ein explizites Seccomp-Profil setzen, z. B.
RuntimeDefault
Beispielsweise kannst du Apache Superset in nur wenigen Schritten aus der Codesphere IDE oder deiner Landscape heraus deployen, direkt in den Virtual Cluster:
helm repo add superset https://apache.github.io/superset
helm repo update
kubectl create namespace superset
helm install superset superset/superset --namespace superset
Sicherheitsrichtlinien
Bei Verwendung eines Virtual Clusters werden Ressourcen in einem dedizierten Kubernetes-Namespace auf dem host cluster angelegt. Dennoch entsteht dadurch eine gemeinsam genutzte Umgebung mit anderen Virtual Clusters im selben Host-Cluster.
Um Sicherheit und Isolation zu gewährleisten, setzt Codesphere für alle Virtual Clusters eine Reihe von Sicherheitsrichtlinien durch. Diese Richtlinien schränken bestimmte Aktionen und Konfigurationen ein, die die Sicherheit oder Stabilität des Host-Clusters gefährden könnten:
- Container müssen als Nicht-Root-Benutzer ausgeführt werden
- Das Seccomp-Profil muss auf
RuntimeDefaultoderLocalhostgesetzt sein - Der Container-SecurityContext muss
allowPrivilegeEscalationauffalsesetzen - Der SecurityContext muss alle Capabilities abgeben (drop)
Das folgende Beispielmanifest zeigt, wie ein Pod konfiguriert werden muss, um diesen Sicherheitsrichtlinien zu entsprechen:
spec:
  template:
    spec:
      securityContext:
        runAsNonRoot: true
        runAsUser: 10001
        runAsGroup: 10001
        seccompProfile:
          type: RuntimeDefault
      containers:
      - name: my-containert
        securityContext:
          allowPrivilegeEscalation: false
          capabilities:
            drop:
            - ALL
Wenn deine Pods nicht den Status RUNNING erreichen, prüfe die Ausgabe von kubectl describe pod auf Warnungen im Zusammenhang mit PodSecurity. Dort können Meldungen wie die folgende auftauchen:
Warning: would violate PodSecurity [...]
Festlegung von Ressourcenlimits
Ein Virtual Cluster verfügt über eine konfigurierbare Quota für Ressourcen. Um zu überprüfen, ob die bereitgestellten Ressourcen innerhalb der Quota liegen, wird erwartet, dass alle Pods in deinem Deployment Ressourcenlimits für CPU, Memory und Ephemeral Storage angeben. Stelle daher sicher, dass deine Pods die folgenden Limits in ihrem Manifest angeben, wie im folgenden Beispiel:
spec:
  template:
    spec:
      containers:
      - name: my-container
        resources:
          limits:
            cpu: "1000m"
            memory: "2Gi"
            ephemeral-storage: "1Gi"
Wenn ein Pod diese Limits nicht angibt, wendet der API-Server folgende Standardwerte an:
limits:
  cpu: "500m"
  memory: "1Gi"
  ephemeral-storage: "6Gi"
Wenn deine Pods nicht den Status RUNNING erreichen, prüfe die Ausgabe von kubectl describe pod auf Warnungen im Zusammenhang mit Quotas. Dort können Meldungen wie die folgende auftauchen:
Error syncing: [...] exceeded quota: vc-k8s [..]
Konnektivität
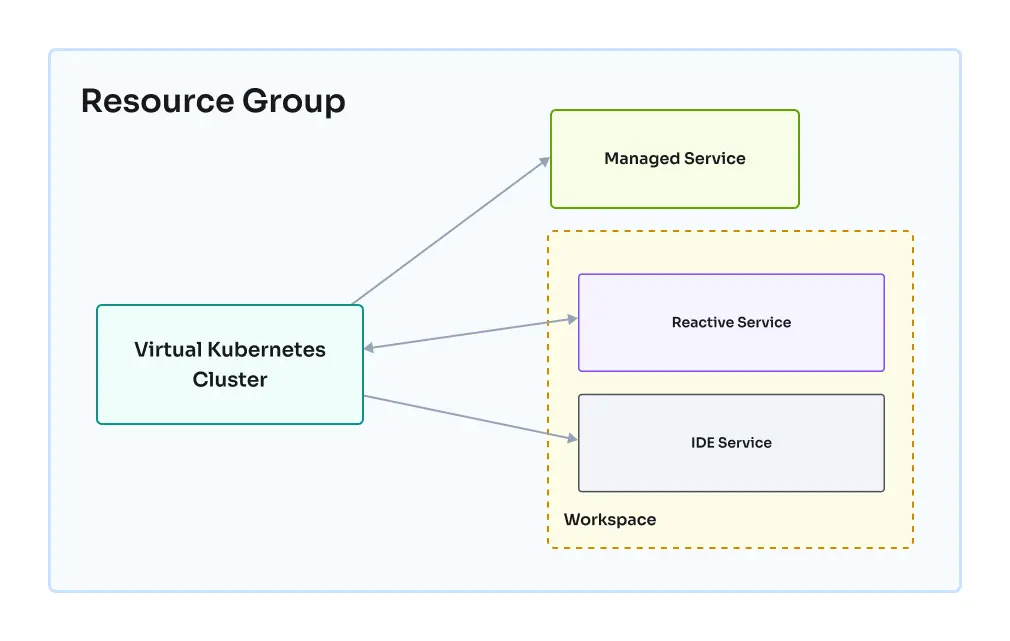
Virtual Clusters sind tief in die Codesphere-Plattform integriert, wodurch es einfach ist, deine Kubernetes-Workloads mit anderen Codesphere-Ressourcen zu verbinden. Als Teil des Codesphere-Host-Clusters können deine Virtual Clusters nahtlos mit Landscapes, Managed Services und anderen Ressourcen innerhalb derselben Resource Group kommunizieren. Diese Integration vereinfacht komplexe Architekturen und ermöglicht leistungsstarke Workflows über deine gesamte Cloud-Infrastruktur hinweg.
Zugehörige barrierefreie Textbeschreibung
Das Virtual-Cluster-Networking unterstützt derzeit nur IPv4. IPv6 wird nicht unterstützt.
Zugriff auf Cluster-Ressourcen
Kubernetes-Pods und -Services, die innerhalb deines Virtual Clusters laufen, sind von jedem Workspace innerhalb derselben Resource Group aus erreichbar. Das bedeutet, du kannst direkt aus deinen Codesphere-Workspaces mit deinen Anwendungen und Services interagieren, was Entwicklung und Fehlersuche effizienter macht.
Um auf einen Service zuzugreifen, der in deinem Virtual Cluster läuft, benötigst du folgende Informationen:
- Den Ressourcennamen (z. B. superset)
- Den Namespace-Namen (z. B. default)
- Die Codesphere-Resource-Group-ID (z. B. 180312) Mit diesen Informationen kannst du deinen Service über eine URL im folgenden Format erreichen:
http://[RESOURCE_NAME]-x-[VIRTUAL_NAMESPACE]-x-k8s.rg-[RESOURCE_GROUP_NAME]
Load-Balancer-Ingress zulassen
Standardmäßig sind Pods innerhalb des Virtual Clusters von externen Load Balancern aus nicht erreichbar. Um eingehenden Load-Balancer-Traffic zu einem Pod zuzulassen, füge dem Pod (oder dessen Pod-Template) das folgende Label hinzu:
codesphere.com/allow-ingress-traffic: "true"
Wenn dieses Label vorhanden ist, wendet die Plattform eine Network Policy an, die eingehenden Traffic von den durch deinen Cluster-Administrator konfigurierten Subnetzen zulässt. Pods ohne dieses Label sind davon nicht betroffen und bleiben vom Load-Balancer-Traffic isoliert.
Wenn du Envoy Gateway in deinem vCluster verwendest, musst du dieses Label der EnvoyProxy-Ressource hinzufügen, um eingehenden Traffic zu allen vom Envoy Gateway verwalteten Routen zuzulassen:
apiVersion: gateway.envoyproxy.io/v1alpha1
kind: EnvoyProxy
metadata:
  name: demo-envoyproxy
  namespace: demo
spec:
  provider:
    type: Kubernetes
    kubernetes:
      envoyDeployment:
        pod:
          labels:
            codesphere.com/allow-ingress-traffic: "true"
Hierfür muss dein Private-Cloud-Administrator die zulässigen Quell-Subnetze über den Helm-Wert global.vcluster.ingressFromSubnets konfiguriert haben. Sind keine Subnetze konfiguriert, wird die Network Policy nicht erstellt und das Label hat keine Wirkung.
Zugriff vom Virtual Cluster aus
Dein Virtual Cluster kann auch auf andere Codesphere-Ressourcen zugreifen, etwa auf Landscapes und Managed Services (zum Beispiel managed Postgres) innerhalb derselben Resource Group. Dies erleichtert den Aufbau komplexer Multi-Service-Anwendungen, die sowohl Kubernetes als auch die Lösungen von Codesphere umfassen.
Um auf einen Workspace-Reactive von deinem Virtual Cluster aus zuzugreifen, benötigst du:
- Den Namen des Landscape-Reactive-Service
- Die ID des Workspace, auf dem das Reactive bereitgestellt ist Anschließend kannst du folgendes URL-Format verwenden:
http://ws-server-[WORKSPACE_ID]-[REACTIVE_NAME].workspaces
Mögliche Anwendungsfälle
- Superset als Helm-Chart deployen
- Grafana deployen und mit einem in Codesphere laufenden Managed-Postgres-Service verbinden
- Prometheus deployen und mit deinen in Codesphere laufenden Anwendungen verbinden, um benutzerdefinierte Metriken zu überwachen
- Eine Custom Resource Definition und Controller hinzufügen (z. B. JSPolicy)
Cluster-Zugriff
Der primäre Weg, um mit deinem Virtual Cluster zu interagieren, ist die kubeconfig-Datei, die direkt in das Dateisystem des Workspace eingespeist wird. Diese Konfigurationsdatei ermöglicht es, kubectl- und helm-Befehle direkt aus dem Workspace-Terminal sowie in den Ausführungsschritten deiner Landscape zu verwenden.
Die Konfigurationsdatei wird automatisch als ~/.kube/config in das Dateisystem des Workspace eingespeist. kubectl und helm verwenden diese Datei standardmäßig als Konfigurationsdatei, um sich mit dem Virtual Cluster zu verbinden.
Du kannst Releases in der Prepare- oder Run-Stage einer Landscape automatisieren und versionieren, indem du Folgendes ausführst:
helm upgrade --install my-release my-charts/my-app --version 2.1.0
Wenn du häufig kubectl eingibst, füge deinem Shell-Profil einen kürzeren Alias hinzu, z. B. alias k=kubectl.
Auslösen einer Konfigurationsaktualisierung
Die Kubeconfig-Datei wird (erneut) in deinen Workspace eingespeist, wenn eines der folgenden Ereignisse eintritt:
- Die Liste der Workspace-Umgebungsvariablen wird geändert
- Der Workspace wird gestartet
- Workspace-Ressourcen werden aktualisiert (z. B. Plan wird geändert, Landscape wird synchronisiert)
Wir arbeiten daran, die Synchronisierung der Kubeconfig-Datei für Landscapes und langlaufende Workspaces zu verbessern. Falls du derzeit Probleme mit einer veralteten oder fehlenden Kubeconfig hast, versuche, eine Umgebungsvariable zu ändern oder deinen Workspace neu zu starten, um eine erneute Einspeisung der Konfigurationsdatei auszulösen.
Abhängigkeiten
Die Binaries kubectl und helm sind im Standard-Codesphere-Workspace-Image vorinstalliert. Wenn du ein benutzerdefiniertes Image verwendest, stelle sicher, dass diese Abhängigkeiten vorhanden sind, falls du mit dem Virtual Cluster interagieren möchtest.
Führe kubectl version aus, um sowohl die Client- als auch die Server-Version zu prüfen. Halte dich gemäß der Upstream-Kubernetes-Version-Skew-Policy daran, deinen kubectl-Client innerhalb einer Minor-Version der Kubernetes-Server-Version des Virtual Clusters zu halten, um Kompatibilitätsprobleme zu vermeiden.
Cluster verwalten
Virtual Clusters stehen als Managed Service in Codesphere zur Verfügung. Der Lebenszyklus der Cluster wird über die Managed-Services-Oberfläche verwaltet, über die du deine Cluster nach Bedarf erstellen, aktualisieren und löschen kannst.
Weitere Details findest du in der Managed-Services-Dokumentation.
Einen Virtual Cluster erstellen
Derzeit kann jede Resource Group aufgrund der Namespace-Beschränkungen der Resource Group nur einen Virtual Cluster besitzen. Prüfe vor dem Erstellen eines neuen Clusters, ob deine Resource Group bereits einen enthält.
Um einen Virtual Cluster zu erstellen, folge diesen Schritten:
-
Gehe zum Tab Managed Services in deinem Codesphere-Workspace.
-
Wähle Virtual Kubernetes Cluster aus dem Service-Katalog. Mit dieser Option kannst du einen neuen Cluster für deine Resource Group einrichten.
-
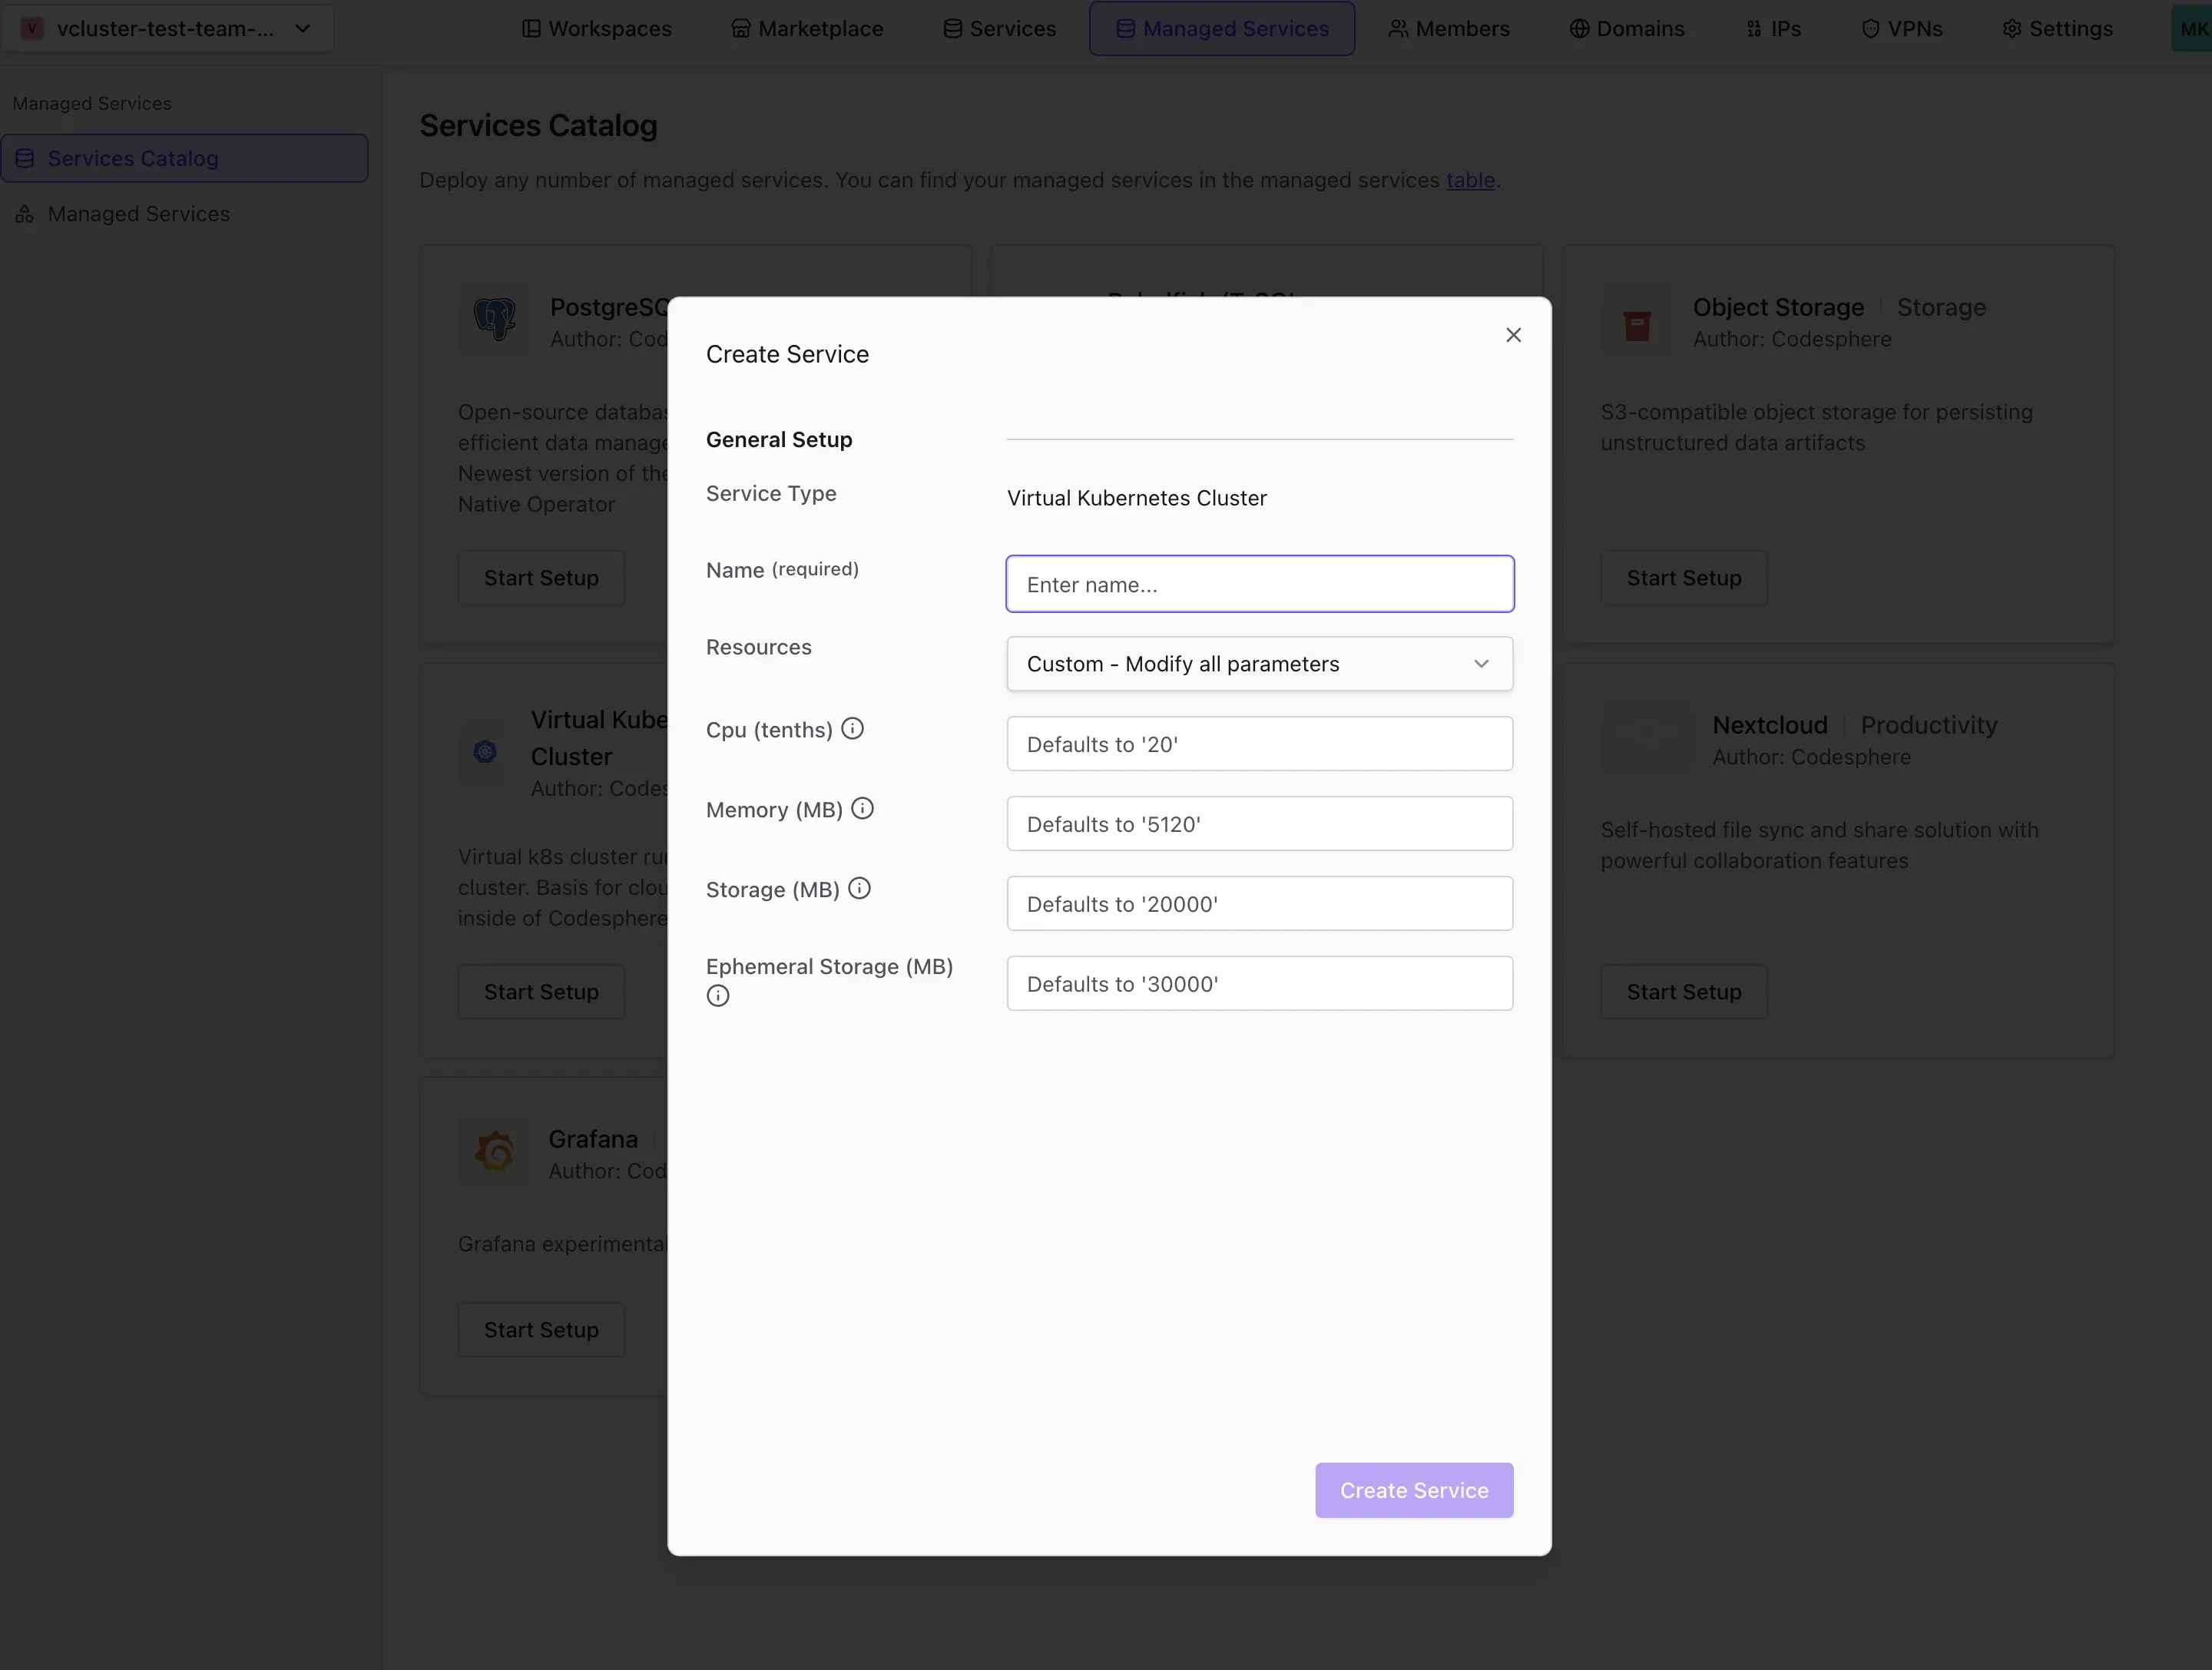
Gib einen Namen ein und nutze die entsprechenden Eingaben, um die Ressourcen-Quota des Virtual Clusters nach deinen Bedürfnissen zu konfigurieren:
- vCPU
- Memory
- Storage
- Ephemeral Storage
Jede Eingabe legt das entsprechende Resource-Quota-Limit für den gesamten Cluster fest — zum Beispiel legt der Memory-Schieberegler den maximal kumulierten Speicher fest, der allen im Cluster laufenden Pods zur Verfügung steht, nicht den Speicher eines einzelnen Pods. Da die Quota auch das Billing bestimmt, solltest du diese Werte an den tatsächlichen Bedarf deines Workloads anpassen, statt sie von vornherein zu maximieren.
-
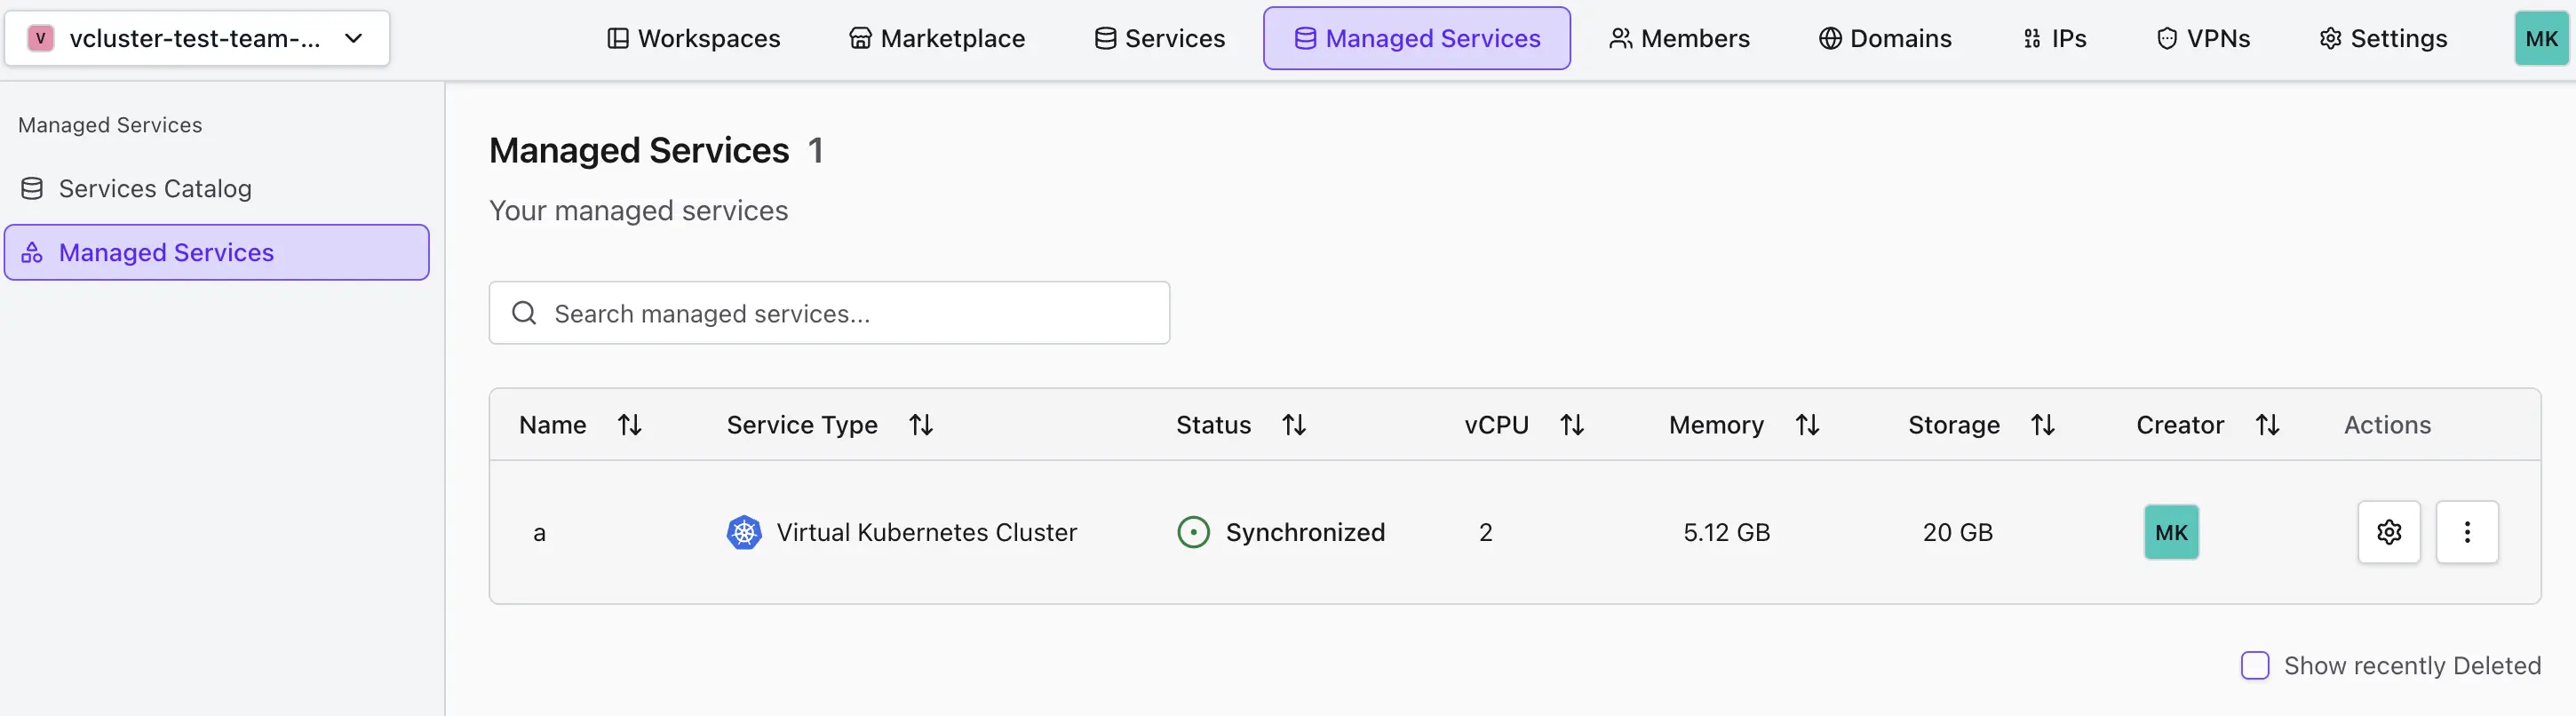
Bestätige und warte, bis der Cluster bereit ist. Die Bereitstellung kann einige Momente dauern.
Den Virtual Cluster ändern
- Gehe zum Tab Managed Services.
- Klicke auf Settings und öffne den Tab Configuration für deinen Cluster.
- Klicke auf Edit Configuration und passe die Ressourcen-Quota-Werte nach Bedarf an.
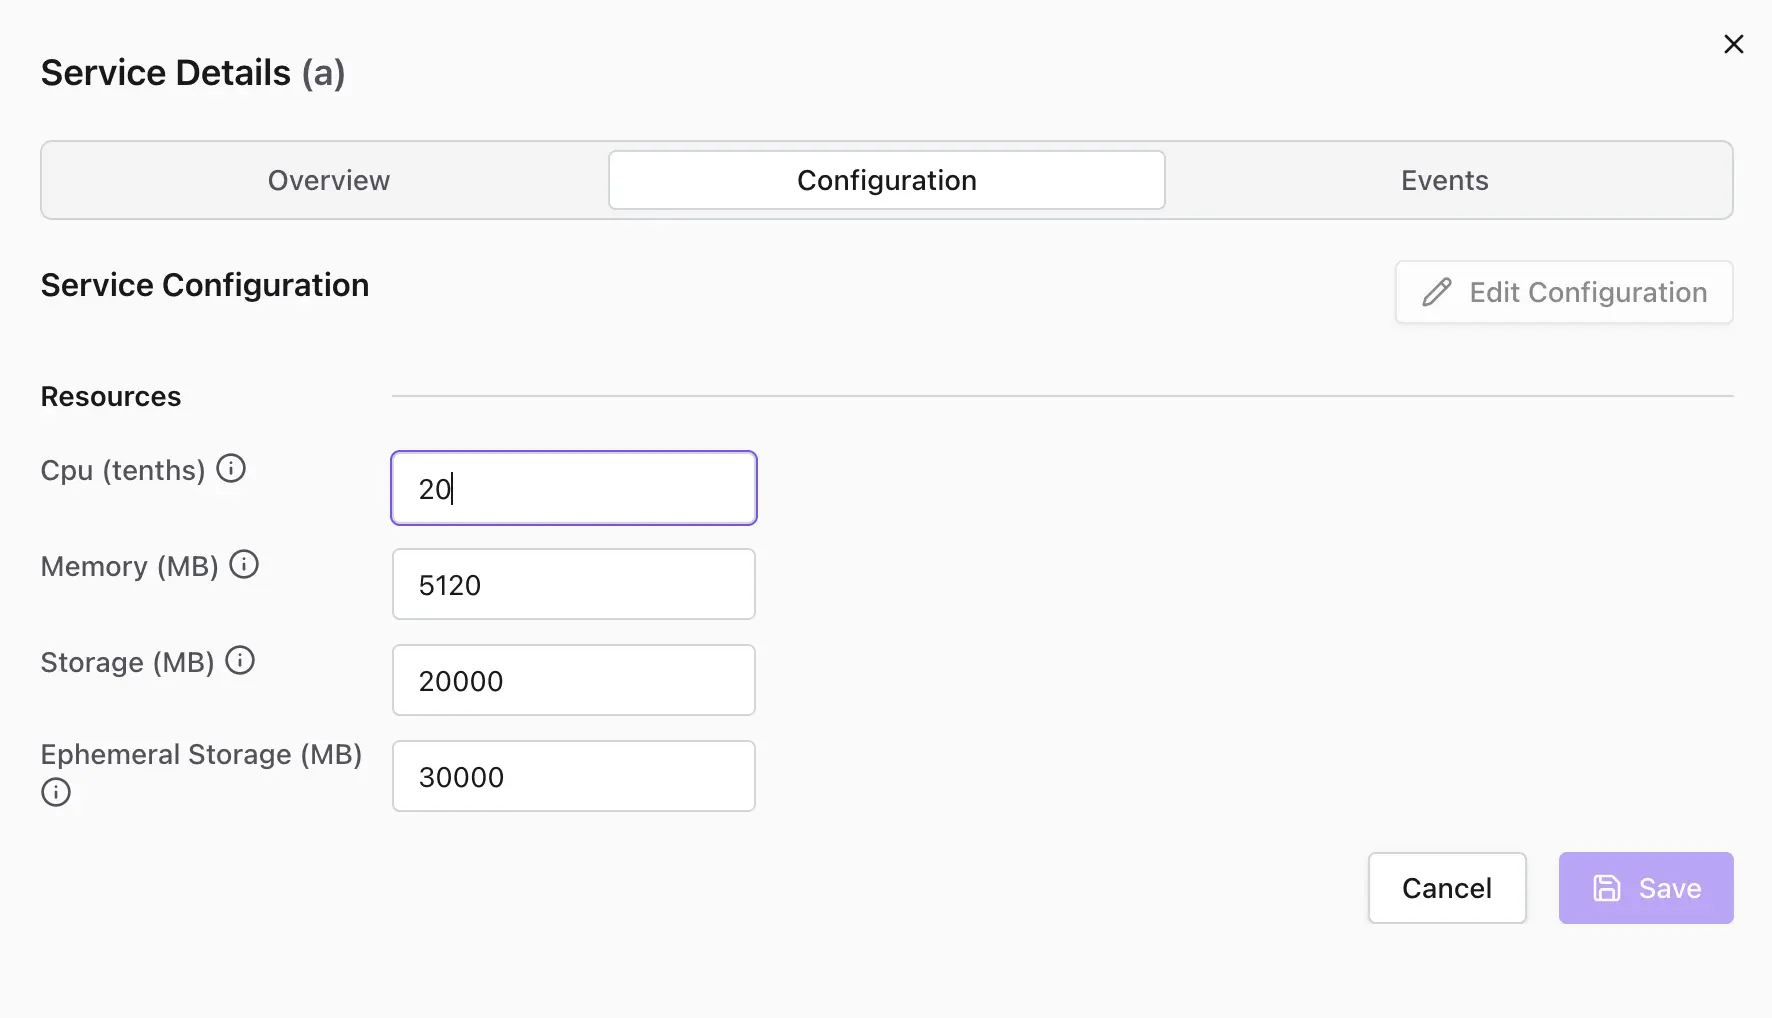
- Bestätige und warte, bis die Änderungen wirksam werden. Der Cluster aktualisiert seine Ressourcen entsprechend.
Resource Quotas des Virtual Clusters
Virtual Clusters setzen Ressourcengrenzen mithilfe der Kubernetes-Objekte ResourceQuota und LimitRange durch. Diese Einstellungen steuern den maximal verfügbaren Memory, CPU, Storage und Ephemeral Storage innerhalb des Clusters.
- Pods müssen Ressourcen-Requests und Limits angeben, um eine faire Nutzung und Planung sicherzustellen
- Gibt ein Pod diese nicht an, wird die Standard-LimitRange angewendet
Die Resource Quota des Virtual Clusters begrenzt derzeit die kumulierten Ressourcenlimits über alle Pods hinweg, nicht die tatsächliche Ressourcennutzung. Wenn Pods nicht geplant werden können, versuche, einzelne Pod-Limits zu senken, damit sie innerhalb deiner Quota liegen.
Die aktuelle LimitRange lautet:
| Typ | Ressource | Standard-Request | Standard-Limit |
|---|---|---|---|
| Container | memory | 128Mi | 2Gi |
| Container | cpu | 100m | 500m |
| Container | ephemeral-storage | 500Mi | 6Gi |
Wie das Billing funktioniert
Virtual Clusters werden auf Basis ihrer konfigurierten Ressourcen-Quota abgerechnet (den vCPU-, Memory-, Storage- und Ephemeral-Storage-Limits, die beim Erstellen oder Ändern des Clusters festgelegt wurden) — nicht auf Basis dessen, was deine Workloads tatsächlich zu einem bestimmten Zeitpunkt verbrauchen.
Das bedeutet, dass das Erhöhen eines Quota-Werts die Kosten erhöht, selbst wenn Pods im Leerlauf sind oder diese Quota nur teilweise nutzen, und dass das Senken eines Quota-Werts die Kosten reduziert, solange deine Workloads weiterhin innerhalb dieser Grenze bleiben.
Beispiel: Wenn du einen Virtual Cluster mit 40 vCPU und 80 GiB Memory konfigurierst, wird dir die Nutzung von 40 vCPU und 80 GiB Memory berechnet — unabhängig davon, ob deine Pods im Leerlauf sind oder diese Ressourcen voll ausnutzen. Um die Kosten zu senken, bemisst du die Quota am tatsächlichen Bedarf deines Workloads, anstatt für ungenutzten Spielraum überzudimensionieren.
Jeder Quota-Parameter (vCPU, Memory, Storage, Ephemeral Storage) wird als separate Einheit abgerechnet. Die genauen Parameterbereiche findest du in der Virtual-Kubernetes-Cluster-Provider-Referenz.
Neue Virtual Clusters verwenden standardmäßig eine Ephemeral-Storage-Quota von 30 GiB, wodurch Pod-Scheduling-Fehler von vornherein zuverlässig vermieden werden, was jedoch mehr ist, als die meisten Workloads benötigen. Wenn deine Pods nicht auf große temporäre Dateien, Caches oder Container-Image-Layer angewiesen sind, solltest du die Ephemeral-Storage-Quota beim Erstellen oder Ändern deines Clusters reduzieren, um Kosten zu sparen.
Fehlerbehebung bei Quota-Fehlern
| Problem | Ursache | Lösung |
|---|---|---|
| Pods können aufgrund von Quota-Fehlern nicht geplant werden | Die Resource Quota des Virtual Clusters ist zu klein, oder die kumulierten Pod-Requests und -Limits überschreiten die konfigurierte Quota | Aktualisiere die Virtual-Cluster-Konfiguration unter Managed Services → dein Virtual Cluster → Settings → Configuration, oder senke einzelne Pod-Requests und -Limits |
Einen Virtual Cluster löschen
Wenn du einen Cluster nicht mehr benötigst:
- Gehe zum Tab Managed Services.
- Klicke auf Actions und wähle Delete für den Cluster, den du entfernen möchtest. Diese Aktion kann nicht rückgängig gemacht werden.
- Bestätige und warte, bis der Cluster entfernt wurde.